


On entend très souvent parler de la consommation des centres de calcul qui servent à faire tourner les modèles d’IA, et notamment les grands modèles de langage comme ChatGPT, Claude, Mistral ou Gemini. Consommation énergétique ou consommation en eau, comme souvent avec le numérique, il est assez difficile de s’en faire une idée intuitive.
Sam Altman, patron d’OpenAI, avait annoncé le chiffre de 0.34 Wh par requête ChatGPT. Mais Altman parle d’une « moyenne », et on ne sait pas forcément très bien d’où sort ce chiffre. Une façon de l’obtenir, ce serait par exemple pour OpenAI de prendre la consommation totale de l’ensemble leurs centres de calcul, et de diviser ça par le nombre de requêtes que ces derniers traitent. C’est une approche «macroscopique» de la question.
A titre d’exercice, je voudrais vous proposer aujourd’hui la démarche opposée : on va prendre une requête, et on va calculer son coût énergétique détaillé en estimant le temps qu’il faut pour la traiter, et la puissance électrique des machines mobilisées.
Attention, je ne pense pas que cette approche « microscopique » du calcul soit intrinsèquement meilleure ou plus précise que l’estimation globale. Mais il me semble qu’elle a au moins 2 vertus pédagogiques.
Premièrement, en prenant des requêtes concrètes, cela permet de voir que la notion de « requête moyenne » cache en fait une très grande diversité de consommations. D’autre part, faire ce calcul va nous forcer à nous pencher sur les détails techniques de cette étape qu’on appelle l’inférence (et qui diffère donc de l’entrainement des modèles). Cela va nous permettre de comprendre comment sont générées les réponses des chatbots au niveau du hardware, ce qui comporte quelques subtilités !
Posons le contexte
Pour faire cet exercice, on va prendre deux cas assez différents : une petite requête et une grosse requête.
Commençons par la petite : vous posez une question simple (100 tokens) à un modèle de taille moyenne (100B, soit 100 milliards de paramètres, les fameux “poids” du modèle), et celui-ci vous produit une réponse d’environ 2 pages de texte (1000 tokens).
Pour la grosse requête, imaginons que vous utilisiez un modèle de très grande taille (500B, donc 500 milliards de paramètres), que vous fournissiez dans le prompt plusieurs documents (5000 tokens en entrée) et que vous lui demandiez une analyse complexe (2000 tokens en sortie, en incluant sa « chaine de pensée », si c’est un modèle avec raisonnement).
Pour calculer le coût énergétique de ces requêtes, il faut donc se demander (1) combien de temps cela va prendre de les traiter, et (2) quelle est la puissance électrique des équipements impliqués. Il suffira alors de les multiplier : l’énergie, c’est la puissance fois le temps.
Concernant les équipements, on va partir sur la base d’une grosse carte graphique moderne, la NVIDIA B200. C’est un modèle sorti fin 2024, et qui est aujourd’hui largement déployé. Je ne vous détaille pas toutes ses spécifications, on le fera au fur et à mesure des besoins.
Une chose que l’on va supposer — et que je justifierai mieux plus tard — c’est que pour la petite requête, on utilise une seule carte B200, et pour la grosse requête on en utilise 8 en parallèle (ce qu’on appelle un « noeud ».)
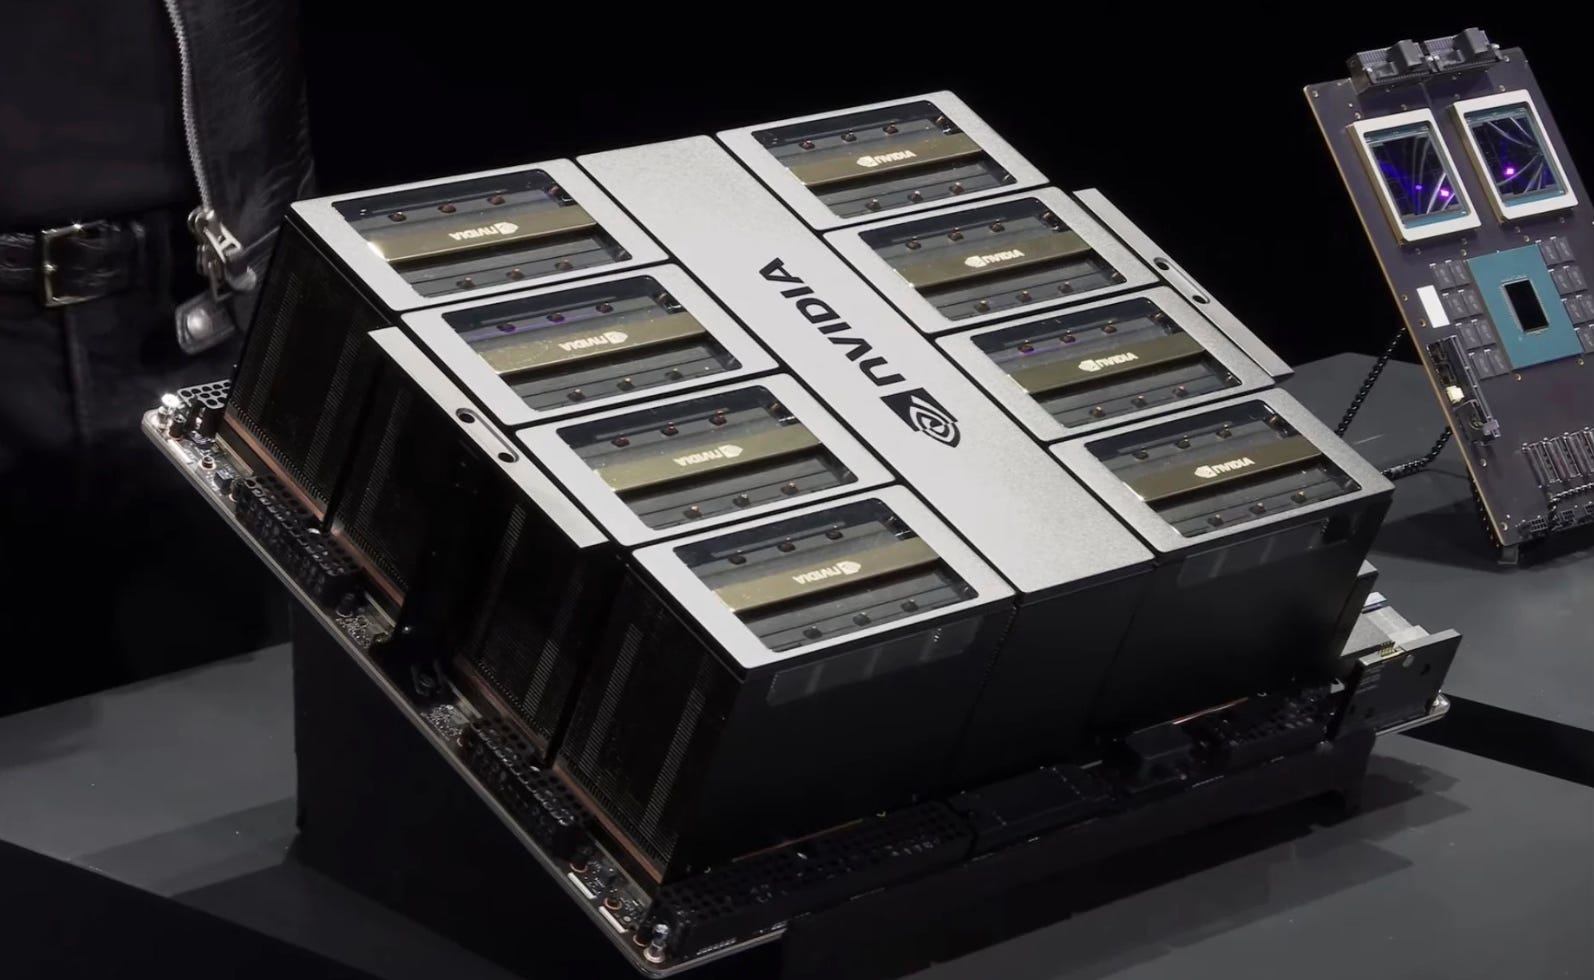
Parlons tout de suite de la puissance mobilisée. En principe une carte B200 peut monter à 1000W quand elle est à pleine puissance de calcul. C’est évidemment le gros de la puissance, mais en comptant l’ensemble du système (stockage, CPU, systèmes auxiliaires, etc.), il faut majorer cette valeur : on peut faire une approximation à 1500W par carte. Dans le langage des centres de calcul, cela revient à supposer une valeur de 1.5 pour le Power Usage Effectiveness (PUE). Pour la grosse requête qui utilise un noeud de 8 GPUs, cela nous fait un total de 12kW.
Maintenant qu’on a la puissance, combien de temps le calcul prend-il ?
Pré-remplissage et décodage
Pour bien estimer les temps et les consommations, il faut réaliser que quand une requête à un LLM est traitée, cela se passe en deux temps.
Tout d’abord votre prompt est en quelque sorte « digéré », c’est la phase de pré-remplissage (ou pre-fill). C’est-à-dire que les tokens qui le composent sont traités par le modèle, qui stocke ensuite en mémoire un grand nombre de données associées qui vont lui re-servir par la suite. C’est ce qu’on appelle le « KV-Cache ». Point important : cette opération peut se faire de façon massivement parallèle, c’est-à-dire que tout se passe comme si l’intégralité de votre prompt était avalé d’un coup.
Ensuite votre réponse est générée, mais cette fois un token après l’autre. C’est la phase de décodage. Pour cette phase, le modèle est contraint de procéder séquentiellement, puisqu’on ne peut pas générer un token si l’on n’a pas déjà déterminé exactement les tokens précédents.
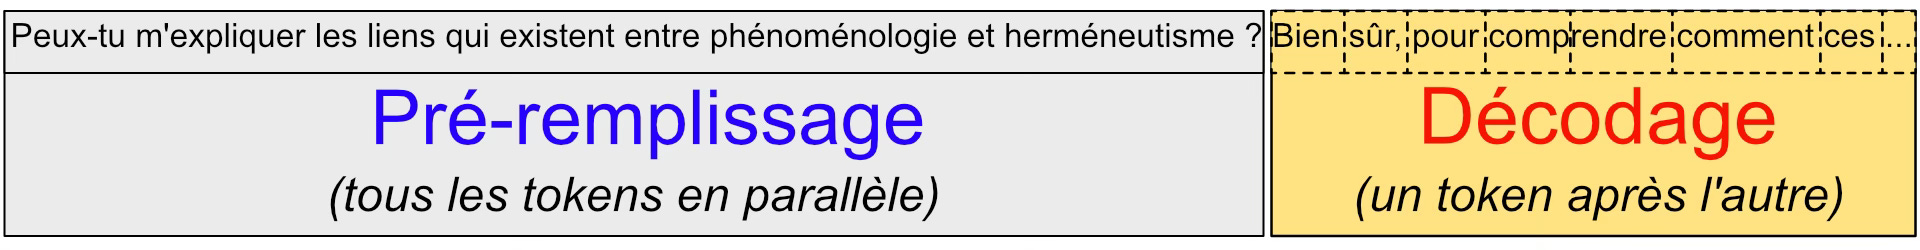
Pour déterminer le temps et la puissance impliqués dans l’opération complète, il va falloir bien distinguer ces deux phases, car elles sont très différentes du point de vue des calculs mobilisés.
La phase de pré-remplissage
La première phase, comme je l’ai dit, s’effectue de façon massivement parallèle. Tous les tokens de votre prompt peuvent potentiellement être traités en même temps. Cela a une conséquence concrète : le temps total nécessaire est directement lié à la vitesse de calcul des processeurs. On parle de phase « compute-bound » (c’est-à-dire « subordonnée au temps de calcul ») Pour estimer le temps que prend cette phase, on a donc besoin de connaitre la quantité d’opérations à effectuer, et la vitesse de calcul du processeur.
Pour la quantité d’opérations, c’est assez simple : pour chaque token, il y a (en simplifiant) une addition et une multiplication à effectuer pour chaque paramètre du modèle. Si N est le nombre de paramètres et L la taille du prompt, le nombre d’opérations pour la phase de pré-remplissage est en gros 2*N*L. L’unité de mesure traditionnelle c’est le « FLOP » pour « floating point operation ». Ou plutôt ici on va parler de « peta-FLOP » (peta=1 million de milliards, ou 10 puissance 15).
Pour ma petite requête de 100 tokens sur un modèle de 100B, on trouve 0.02 peta-FLOPS. Et pour ma grosse requête de 5000 tokens sur un modèle 500B, ça fait 5 peta flops.
Maintenant, combien une carte graphique B200 est-elle capable de traiter d’opérations ? Eh bien cela dépend notamment de la façon dont sont stockés les nombres en mémoire. En général, en informatique, un nombre flottant « normal » est stocké sur 32 bits. Mais on a découvert que pour l’étape d’inférence des LLMs, on pouvait largement réduire le stockage sans trop dégrader les performances. C’est ce qu’on appelle la « quantization ». Les modèles manipulent donc généralement des nombres en 16 bits ou 8 bits, voire parfois moins pour les modèles qui sont agressivement « quantizés ». Pour notre calcul, faisons l’hypothèse que notre gros modèle est en 16 bits, et le plus petit en 8 bits (respectivement 2 octets et 1 octet; pour les connaisseurs, les formats BF16 et FP8).
Pour des opérations 16 bits, la carte B200 tourne à 2.25 peta-FLOP par seconde, mais elle monte à 4.5 peta-FLOP par seconde pour du 8 bits. Pour la petite requête, on trouve un temps de traitement d’environ 4 millisecondes. Pour la grosse requête (en exploitant les 8 GPU du noeud), on est à 280ms.
Passons maintenant à la seconde phase, qui est plus subtile.
Décodage et bande passante
Je vous ai expliqué que la phase de pré-remplissage était compute-bound, c’est-à-dire limitée par la vitesse de calcul disponible. Dans mon compte, j’ai fait comme si, dès qu’un prompt arrivait, toute la carte graphique était mobilisée à son traitement. En pratique ça n’est pas forcément le cas : on peut imaginer paralléliser le pré-remplissage de plusieurs requêtes sur une même carte. Cela va allonger le temps de traitement (et donc la latence perçue par l’utilisateur), mais ça ne change pas le calcul : le coût énergétique d’une opération élémentaire est toujours le même.
Pour la seconde phase, c’est différent. Les tokens sont générés les uns après les autres. Pour générer un seul token, vous devez effectuer des opérations qui impliquent l’ensemble des poids du modèle, chacun des poids n’interviendra que dans deux opérations (une addition et une multiplication).
Or pour qu’un poids puisse participer à un calcul, il doit être chargé depuis la mémoire et stocké provisoirement dans un processeur. Le processeur ne peut pas opérer directement sur les données de la mémoire, il faut d’abord lui apporter ces données, et cette opération prend beaucoup plus de temps que le calcul lui-même !
Cela a une conséquence importante : la phase de décodage n’est pas limitée par la vitesse de calcul mais par la bande passante de la mémoire. Elle n’est pas « compute-bound » comme la phase de pré-remplissage, elle est « memory-bound ». Et ce qui va déterminer le temps de génération d’un token, et donc le débit en « nombre de tokens par seconde », c’est la bande passante de la mémoire de la carte graphique, plutôt que sa vitesse de calcul. Pour une B200, cette bande passante est de 8 tera-octets par seconde.
Pour notre petit modèle de 100 milliards de paramètres, cela représente une vitesse de génération de 80 tokens par seconde, et donc un temps total de génération d’environ 12 secondes pour une réponse de 1000 tokens. Pour notre gros modèle qui tourne sur un noeud de 8 cartes, on est à 64 tokens par seconde, et il faudra autour de 30 secondes pour générer l’ensemble de la réponse (2000 tokens).
On voit donc que, du fait de la génération token par token, les temps de décodage sont bien plus importants que les temps de pré-remplissage. Intuitivement, on pourrait se dire que du point de vue de la consommation, seul le décodage compte, et donc qu’on a plus qu’à multiplier ce temps par la puissance de l’installation pour obtenir une estimation de l’énergie consommée. Mais c’est ignorer un aspect essentiel du problème : le possibilité de traiter plusieurs requêtes en parallèle.
Le batching des requêtes
Je vous l’ai dit, lors de la phase de décodage, on doit charger un poids en mémoire avant de pouvoir l’utiliser pour un calcul. Et ici le chargement d’un poids prend environ 300 fois plus de temps que le calcul qu’on effectuera avec pour générer un token. On comprend donc que, pour cette phase, on a grandement intérêt à paralléliser les requêtes ! Si l’essentiel du temps passé, c’est de charger un poids en mémoire, une fois qu’il est là, autant l’utiliser pour contribuer à la prédiction du prochain token de tout un tas de requêtes à la fois.
Une grande partie de l’ingénierie des opérations d’inférence, c’est donc de faire en sorte qu’on puisse packager un maximum de requêtes, afin de les traiter ensemble (en un seul batch) dans la phase de décodage. Mais combien peut-on en traiter simultanément ? Cela dépend de la place en mémoire !
Vous savez peut-être que la mémoire des GPU, c’est un peu le nerf de la guerre. Et pourtant je n’en ai pas parlé jusqu’ici ! Voyons à quoi elle nous sert. Tout d’abord, elle est indispensable à stocker les poids des modèles.
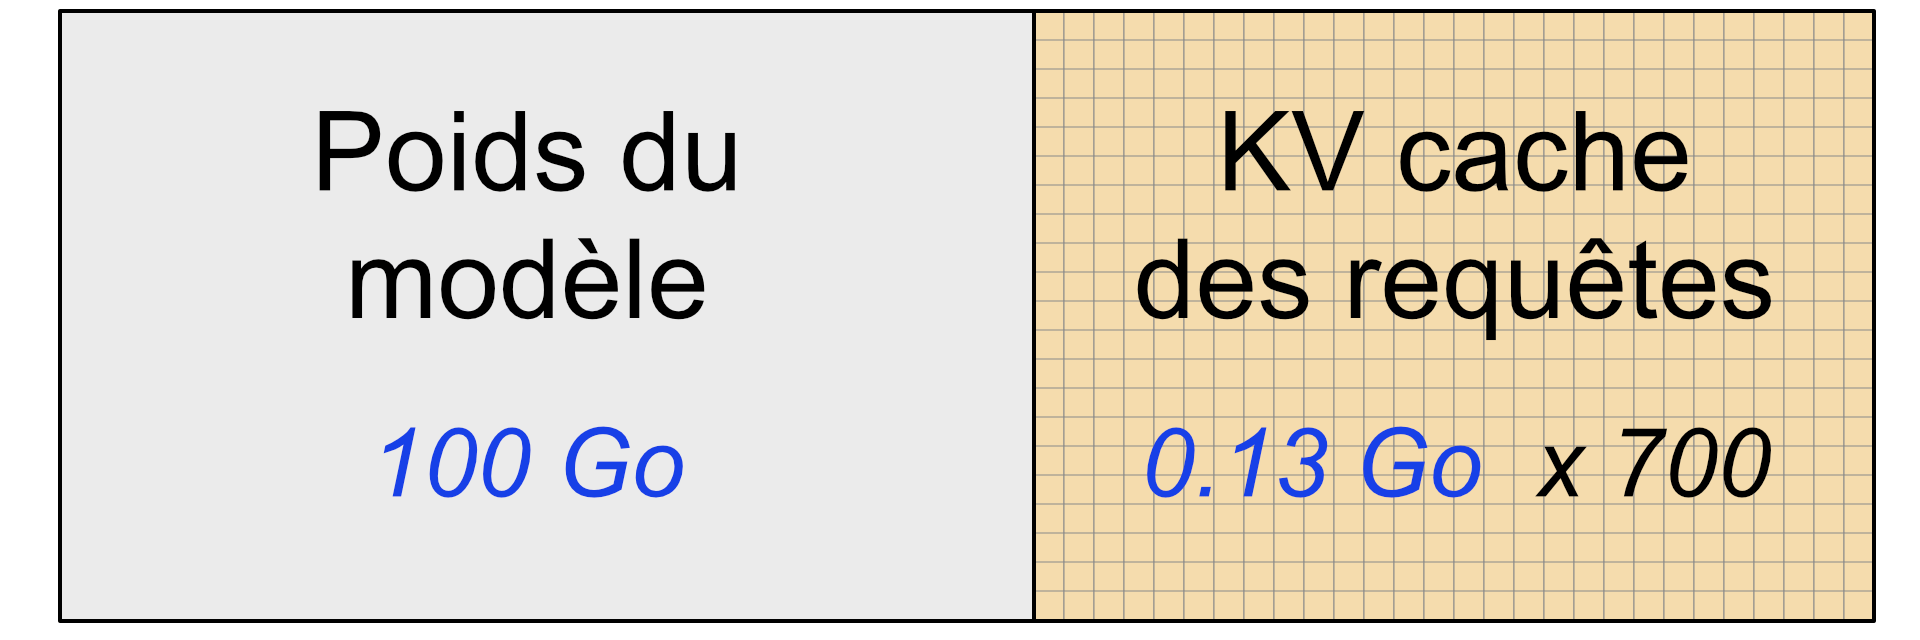
Notre « petit » modèle 100B quantizé en 8 bits (donc un octet par poids) aura besoin de 100 Gigaoctets de mémoire. Une B200 a une mémoire de 192Go, ça tient donc largement, et il nous reste 92Go de libre (en vrai un peu moins, mais faisons simple). Pour notre gros modèle 500B quantizé en 16 bits (2 octets par poids), ça fait 1000 Gigaoctets. On va donc devoir en théorie utiliser au moins 6 cartes simultanément. Mais tant qu’à faire, autant utiliser un noeud complet avec 8 cartes. La mémoire totale sera de 1536Go, il restera donc 536Go de libre une fois le modèle stocké.
Le point clé, c’est que la mémoire des GPUs ne sert pas seulement à stocker les poids du modèle, mais aussi tous les calculs intermédiaires qui nécessitent d’être réutilisés d’un token sur l’autre. C’est le KV-cache dont je vous ai parlé plus haut, et qui doit être stocké tant pour le prompt que pour chacun des tokens au fur et à mesure de leur génération. Et pour savoir combien de requêtes on peut traiter en parallèle, on va devoir estimer combien on peut en caser simultanément dans la mémoire.
Quelle quantité de mémoire occupe un token dans le KV-cache ? Cela dépend de l’architecture du modèle (notamment du nombre de couches, des dimensions et du mécanisme d’attention) mais aussi de la précision avec laquelle on stocke les nombres. Je vous passe les détails, mais on va prendre 120ko par token pour le petit modèle, et 160ko pour le gros.
Vu la taille totale des requêtes (100+1000 pour la petite, 5000+2000 tokens pour la grosse), on trouve que la place restante en mémoire permet de stocker le KV-cache de 700 requêtes dans le premier cas (sur un seul GPU), et presque 500 dans le second (sur un noeud de 8 GPUs).
Mais ne rêvons pas, il est peu probable que les fournisseurs de service d’inférence arrivent à remplir avec autant d’efficacité leurs processeurs. Cela supposerait d’avoir à chaque instant suffisamment de requêtes de même taille à dispatcher, de prendre un peu de marge car on ne connait pas avec certitude la longueur du texte généré. Considérons que le facteur effectif de remplissage soit de seulement disons 30% des valeurs théoriques, donc respectivement 210 et 150.
On connait ainsi maintenant le nombre de requêtes traitées en parallèle. Le coût énergétique total associé à l’étape de décodage doit donc être réparti sur l’ensemble de ces requêtes. Pour la petite requête, on avait un temps de génération de 12.5 secondes, mais si 210 requêtes sont traitées simultanément, c’est comme si le temps de génération effectif était de seulement 60ms (c’est-à-dire que tout se passe comme si l’ensemble de l’installation était mobilisé en moyenne 60ms sur chaque requête). Pour la grosse requête, si on arrive à en paralléliser 150, le temps de génération effectif tombe de 30s à 220 millisecondes.
Le bilan
Faisons le bilan. Si on cumule le temps de pré-remplissage et le temps de décodage effectif, on arrive pour la petite requête à environ 65ms sur une installation de 1500W, c’est-à-dire environ 0.027Wh (100 Joules).
Et pour la grosse requête, on est à 500ms sur une installation de 12000W, ça fait 1,6Wh. (6000 Joules). Notez que malgré le remplissage de seulement 30%, j’ai considéré que les cartes consommaient leur maximum de puissance : c’est probablement sur-estimé mais soyons conservateurs.
Première observation : la moyenne fréquemment citée de 0.3Wh par requête n’est pas absurde. Même si le chiffre date je crois de l’époque de GPT4o, on voit qu’en prenant en compte l’évolution des usages, des architectures et du hardware, on reste dans les mêmes ordres de grandeur. Mais surtout, on voit un facteur 60 entre une petite et une grosse requête. La notion de « requête moyenne » cache en fait une grande diversité de situations.
Et l’eau dans tout ça ?
Petit passage obligé sur la consommation d’eau, mais on va faire simple. L’eau est utilisée dans les centres de calcul pour refroidir les équipements. Eh oui, en physique l’énergie se conserve. Et donc quand un équipement fonctionne à une puissance de 12kW, toute l’énergie ainsi produite se transforme in fine essentiellement en chaleur. Et cette chaleur, il faut l’évacuer.
Pour refroidir un processeur, il y a plusieurs moyens. Sur votre ordinateur personnel, il y a généralement un ventilateur et donc la chaleur se retrouve dans l’air. Mais dans un centre de calcul, il y a bien trop de chaleur produite. Il faut de fait l’évacuer d’une façon plus efficace. Si l’on se trouve à côté d’une source d’eau courante (disons un fleuve), on peut y pomper de l’eau, la chauffer et la rejeter plus chaude en aval. Techniquement ça ne consomme pas d’eau (mais ça peut avoir d’autres impacts, notamment sur les écosystèmes.)
Mais comme les centres de calcul ne sont pas forcément à côté d’une telle source, on va faire une hypothèse simplifiée (mais probablement assez proche de la réalité) : que toute la chaleur est évacuée en faisant évaporer de l’eau courante.
Imaginez de l’eau entrante à 20°C. La capacité calorifique de l’eau, c’est 4.2 J/g/K. Donc chauffer un gramme d’eau de 20 à 100°C, permet d’évacuer environ 340J de chaleur. Maintenant si une fois arrivé à 100°C vous continuez à chauffer pour faire évaporer l’eau, cela absorbe à nouveau de la chaleur : celle nécessaire à la réalisation de la transition de phase.
La chaleur latente de changement de phase, c’est, pour l’ébullition de l’eau, 2260 J par gramme. On voit que l’évaporation est incroyablement efficace pour absorber de la chaleur. Faire évaporer complètement une certaine masse d’eau demande 8 fois plus d’énergie que de simplement la chauffer de 20°C à 100°C. En sommant les deux, on voit que le « pouvoir d’absorption de chaleur » d’un gramme d’eau que l’on passerait de 20°C à l’état de vapeur à 100°C, c’est environ 2600 J.
Ca veut dire que pour évacuer 1kWh de chaleur, il vous faudra consommer en gros 1.4L d’eau, et on peut considérer cela comme une hypothèse conservatrice puisque j’ai supposé que le refroidissement était purement évaporatif. Cette quantité (en litres d’eau par kWh), c’est ce qu’on appelle « Water Usage Effectiveness » (ou WUE), et les valeurs publiées sont en général en-dessous (entre 0.6 et 1.2 suivant les centres de calcul). Malgré tout, vous pouvez retenir l’ordre de grandeur « 1 kWh d’énergie dépensée dans un centre de calcul, c’est en gros un litre d’eau évaporé ». En restant sur 1.4L, si on met ça en regard de nos requêtes, cela fait une consommation de 0.04 g d’eau pour la petite requête, et 2.3g pour la grosse (voir ici pour des ordres de grandeur d’empreinte eau)
Notez que ces valeurs sont probablement à majorer du fait d’une autre contribution : l’eau nécessaire à produire l’électricité. Si le WUE du refroidissement est de l’ordre de 1L/kWh (parfois appelé WUE on-site), le WUE associé à la production d’électricité (off-site) semble plus élevé, mais dépend fortement de la source d’électricité.
Quelques compléments pour aller plus loin
Je vous mets ci-dessous un petit résumé de mes calculs, avec les différentes données d’entrée et les différentes opérations.
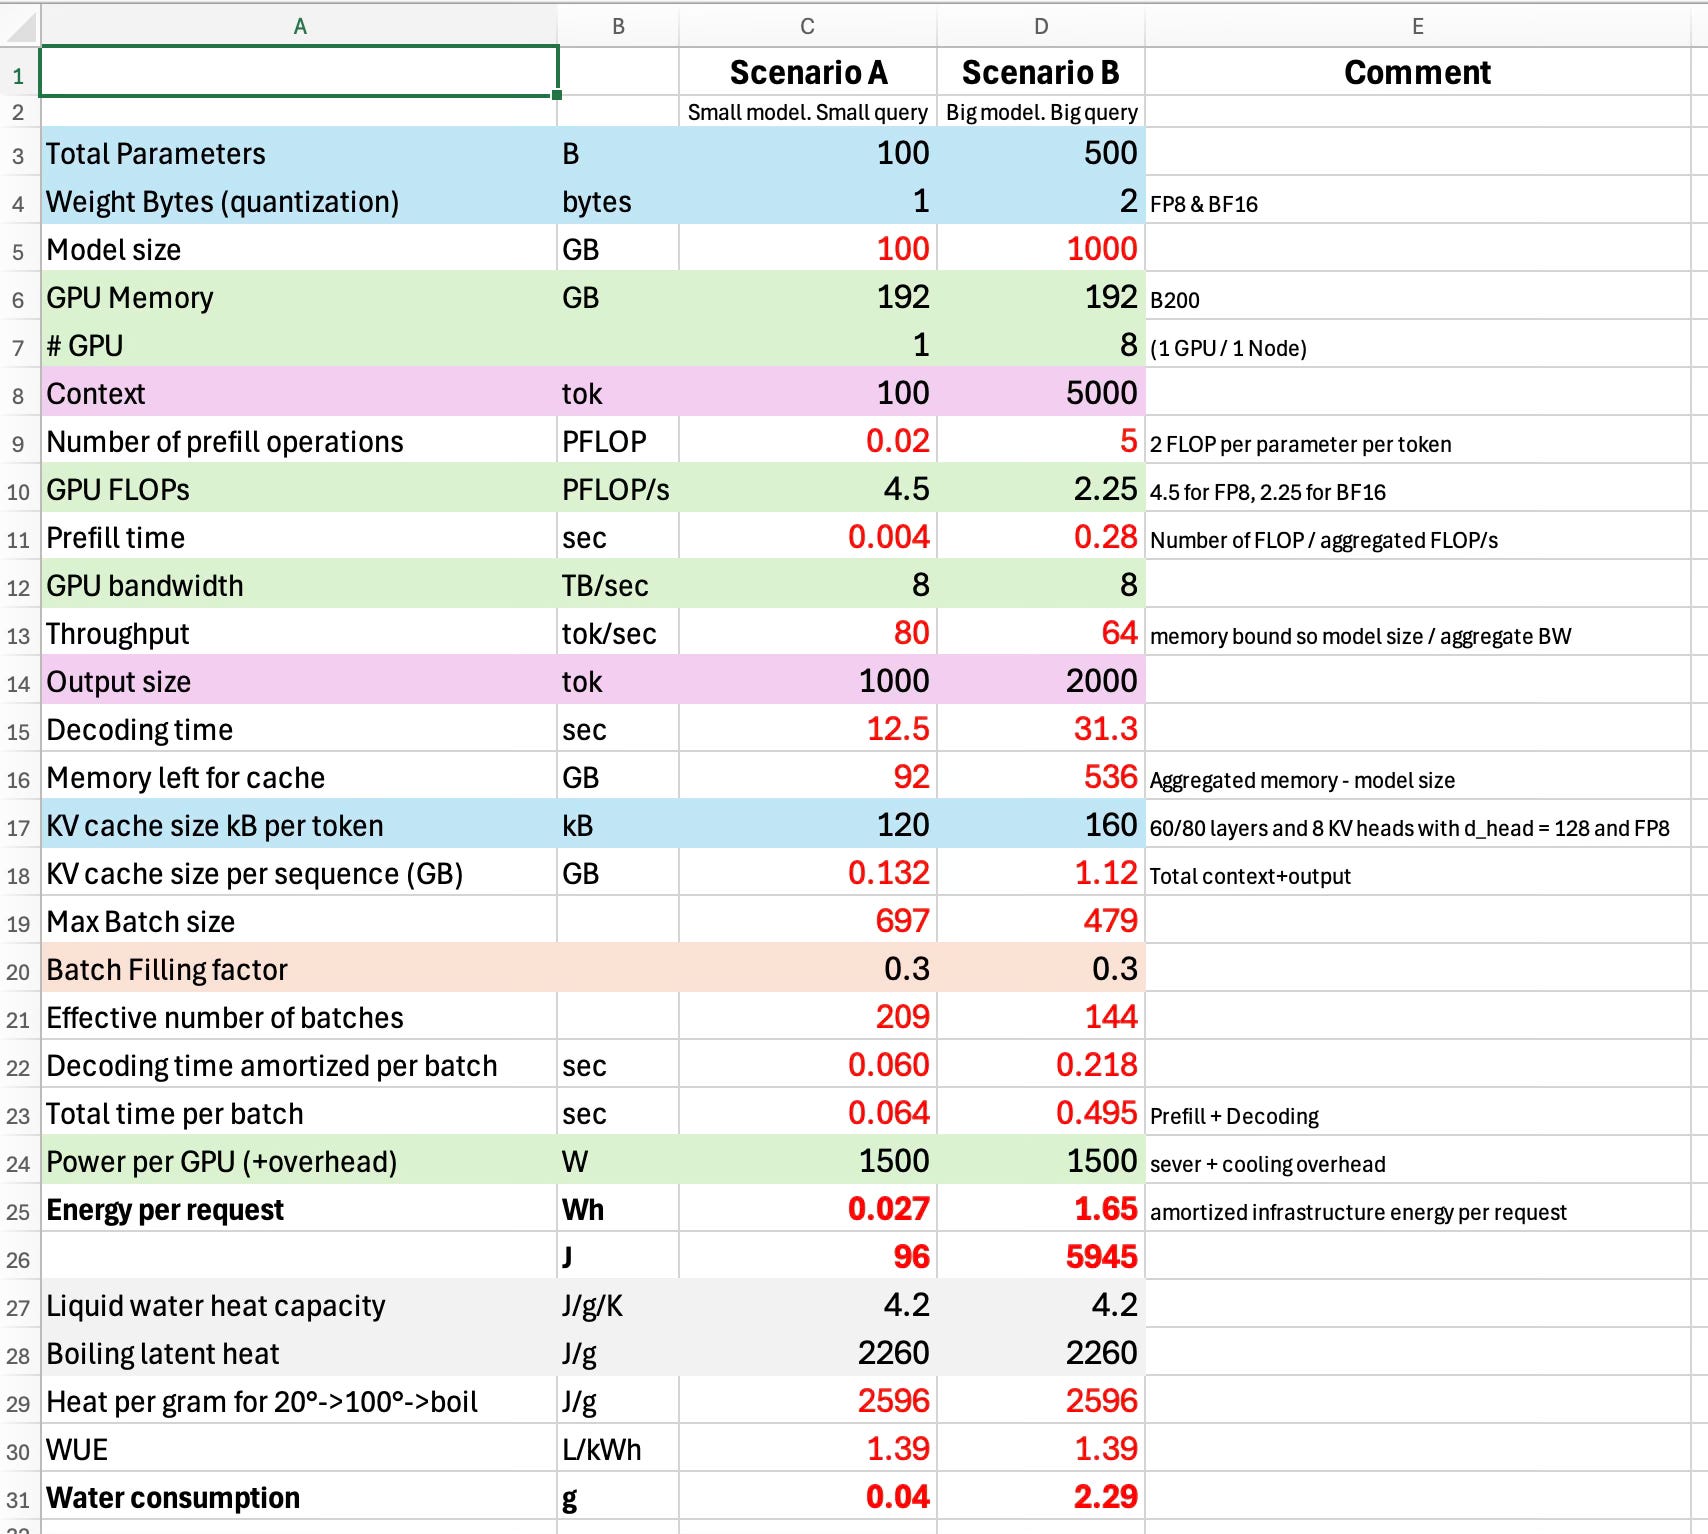
Ce calcul n’est pas parfait, loin de là, et à nouveau mon but ici était surtout de vous parler des différentes étapes impliquées dans l’opération d’inférence, et notamment ces subtilités liées à la phase de décodage, la nécessité de batcher les requêtes, et les facteurs limitants des GPUs.
De nombreux éléments que j’ai négligés dans cette affaire : les temps de calcul pour l’entrainement (aujourd’hui pour les modèles les plus utilisés, il est assez inférieur aux temps de calculs pour l’inférence puisque l’entrainement de ces modèles est un coût fixe amorti sur de nombreuses requêtes), les subtilités d’architecture comme les Mixture Of Experts, les consommations associées à l’appareil sur lequel on fait sa requête (téléphone, ordinateur…), les ressources matérielles, l’eau et l’énergie dite “grises” nécessaires à la fabrication du hardware (aussi bien le hardware des centres de calcul que celui des appareils domestiques), les questions de maintenance, etc. Mais (et je me répète), mon but n’était pas de trouver une valeur unique absolue, mais de jouer un peu avec les bons ordres de grandeur.
J’ai aussi décidé de me concentrer sur la génération de texte, qui me semble l’usage à la fois le plus important et le plus utile. Les modèles vidéo notamment consomment certainement beaucoup plus par requête…pour un bénéfice qu’on peut discuter. Mais je connais moins ces modèles et leur usage global est je pense assez limité.
Sinon pour le refroidissement évaporatif, j’ai supposé qu’on allait jusqu’à 100°C avant de faire l’ébullition, mais ça n’est pas forcément le cas. Mais vu que la chaleur latente est grande devant la capacité calorifique, l’ordre de grandeur reste correct.
Si vous voulez creuser les aspects scientifiques et techniques des méthodes d’inférence, et notamment la façon de traiter en batch les requêtes, vous pouvez regarder le papier vLLM et le principe de la Paged Attention qui est derrière.
Bonjour, un jour il faudra parler de la "consommation" de l'eau et du fameux kilo de bœuf qui aurait "consommé" plusieurs tonnes d'eau
A la fin tu dis que l'entrainement de l'IA a un coût négligeable. C'est fou, je pensais que l'entrainement d'une IA coutait une énergie "de dingue"! J'ai demandé une explication à chatGPT himself qui m'a expliqué que l'entrainement coûte environ l'équivalent de 3 milliards de requêtes. Mais c'est négligeable puisqu'il a environ 1 milliard de requêtes par jour!! Pas habitué à ces chiffres, moi :D